
Kostenlose Dokumentenextraktion
Extrahiere die Überschriften, Absätze, Tabellen und Bilder von PDF-Dateien, Scans, Word, PowerPoint und Excel-Dateien in Markdown und JSON.
Bis zu 501 Seiten pro PDF und keine monatliche Obergrenze; Kostenlose Extraktionen warten in einer Warteschlange. Für große Akten oder wenn Sie es eilig haben, empfehlen wir esdie OmniDoc Desktop-App: Kein Seitenlimit und keine Warteschlange.
So konvertieren Sie ein PDF in Markdown und JSON
- 1Laden Sie die Datei hochMelde dich mit einem OmniDoc-Konto an, dann leg die Datei oben in den Bereich oder klicke auf "Datei auswählen".
- 2Beginne mit der ExtraktionPDF Dateien, Scans und Bilder durchlaufen eine Layoutanalyse, Texterkennung und Tabellenerkennung; Word-, PowerPoint- und Excel-Dateien, E-Books und Webseiten werden direkt analysiert.
- 3Laden Sie das Ergebnis herunterWenn es fertig ist, lade eine ZIP-Datei mit Markdown, JSON und den Bildern herunter.
Beispiel
Seite 1 eines Berichts und das daraus extrahierte Markdown: Überschriftenebenen, Absätze und Tabellen bleiben erhalten.
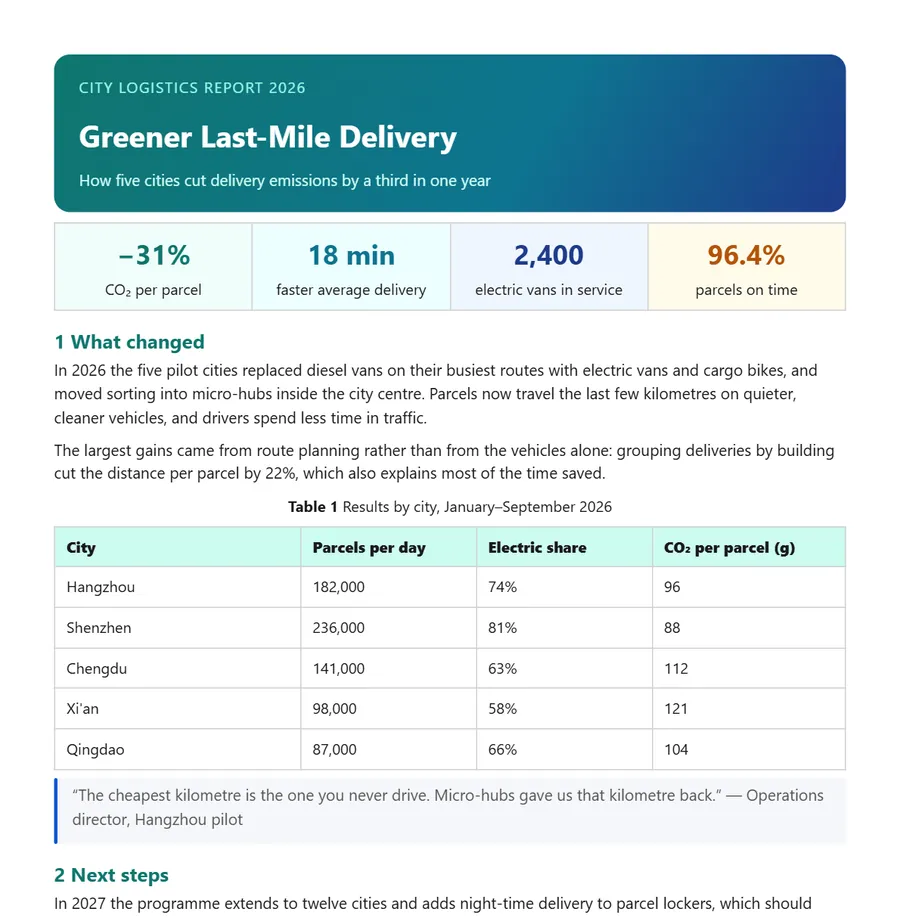
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
Die Datei ZIP, die Sie herunterladen, enthält
document.mdDer vollständige Text als Markdowndocument.jsonStrukturierte Daten in Lesereihenfolgeimages/Die Bilder im Dokumentmanifest.jsonEine Liste der Dateien mit grundlegenden Informationen
Unterstützte Formate
| Akte | Wie es verarbeitet wird |
|---|---|
| PDF, gescannte PDF, PNG, JPG, WEBP und BMP Bilder | Layout-Analyse, Texterkennung (OCR) und Tabellenerkennung |
| Word、PowerPoint、Excel、CSV | Die Dokumentstruktur wird direkt gelesen |
| EPUB E-Books, HTML Seiten | Kapitel und Textkörper werden analysiert |
| Markdown, TXT, SRT und ASS Untertitel | Konvertiert in dasselbe Markdown und JSON |
Fragen
Welche Dateien enthält das Ergebnis?
Eine ZIP-Datei mit document.md (der Volltext als Markdown), document.json (strukturierte Daten), images/ (die Bilder) und manifest.json (eine Liste der Dateien).
Können Scans extrahiert werden?
Ja. Gescannte PDF-Dateien und -Bilder werden zuerst erkannt und dann organisiert. Vergleichen Sie den erkannten Text mit dem Original, insbesondere mit Zahlen und Tabellen.
Wo liegen die Grenzen der freien Extraktion?
Bis zu 501 Seiten pro PDF und keine monatliche Obergrenze. Kostenlose Extraktionen werden in der Reihenfolge ihrer Übermittlung verarbeitet, sodass die Geschwindigkeit von der Warteschlange abhängt. Wir geben unser Bestes in Sachen Qualität; Wenn ein Ergebnis nicht gut genug ist, haben Sie bitte Geduld. Für große Dateien oder wenn Sie es eilig haben, empfehlen wir die Desktop-App OmniDoc: keine Seitenbeschränkung und keine Warteschlange.
Wie unterscheidet sich das vom Kopieren des Textes?
Die Extraktion behält die Überschriften, Absätze, Tabellen und Bilder und deren Zusammenhängung bei, sodass strukturierte Daten statt Klartext erhalten.
Brauche ich ein Konto?
Ja. Melden Sie sich mit einem OmniDoc-Konto an. Die Anmeldung ist kostenlos. Nur Sie können die von Ihnen hochgeladenen Dateien und deren Ergebnisse sehen.
Wo lade ich das Ergebnis herunter?
Laden Sie es auf dieser Seite herunter, wenn es fertig ist. Die Extraktion läuft im Hintergrund, sodass das Verlassen der Seite keine Auswirkungen darauf hat. Öffnen Sie diese Seite erneut und melden Sie sich an, um unter „Letzte Extraktionen“ nach früheren Dateien zu suchen.
Was, wenn die Dateiendung nicht mit dem echten Format übereinstimmt?
Das tatsächliche Format wird anhand des Dateiinhalts ermittelt. Beispielsweise wird eine PDF-Datei, die eigentlich ein Word-Dokument ist, als .docx verarbeitet und als .docx zurückgegeben. Speichern Sie zunächst alte .doc-, .xls- und .ppt-Dateien als .docx, .xlsx und .pptx.
Muss ich etwas installieren?
Nein, es läuft im Browser. Für Dateien mit vielen Seiten oder wenn Sie es eilig haben, empfehlen wir die OmniDoc-Desktop-App für Windows, macOS und Linux: kein Seitenlimit und keine Warteschlange.
Die OmniDoc Desktop-App: flüssig, 100 % Office-XML-Unterstützung, Chinas neue nationale Standards
Die kostenlose Desktop-App für Windows, macOS und Linux öffnet, bearbeitet und speichert Dateien auf Ihrem eigenen Computer.