
무료 문서 추출
PDF 파일, 스캔, Word, PowerPoint 및 Excel 파일의 제목, 단락, 표 및 이미지를 Markdown 및 JSON로 추출합니다.
PDF당 최대 501페이지까지 가능하며 월간 제한이 없습니다; 무료 추출은 대기열에 서 있습니다. 큰 파일이나 급할 때는 추천합니다OmniDoc 데스크톱 앱: 페이지 제한도 없고 대기열도 없습니다.
PDF을 Markdown 및 JSON로 변환하는 방법
- 1파일 업로드OmniDoc 계정으로 로그인한 후, 위 영역에 파일을 놓거나 "파일 선택"을 클릭하세요.
- 2추출 시작PDF 파일, 스캔 및 이미지는 레이아웃 분석, 텍스트 인식 및 테이블 인식을 거칩니다. Word, PowerPoint 및 Excel 파일, 전자책 및 웹페이지가 직접 구문 분석됩니다.
- 3결과 다운로드완료되면 Markdown, JSON 및 이미지가 포함된 ZIP 파일을 다운로드합니다.
예
보고서의 페이지 1 및 여기에서 추출된 Markdown: 제목 수준, 단락 및 표가 유지됩니다.
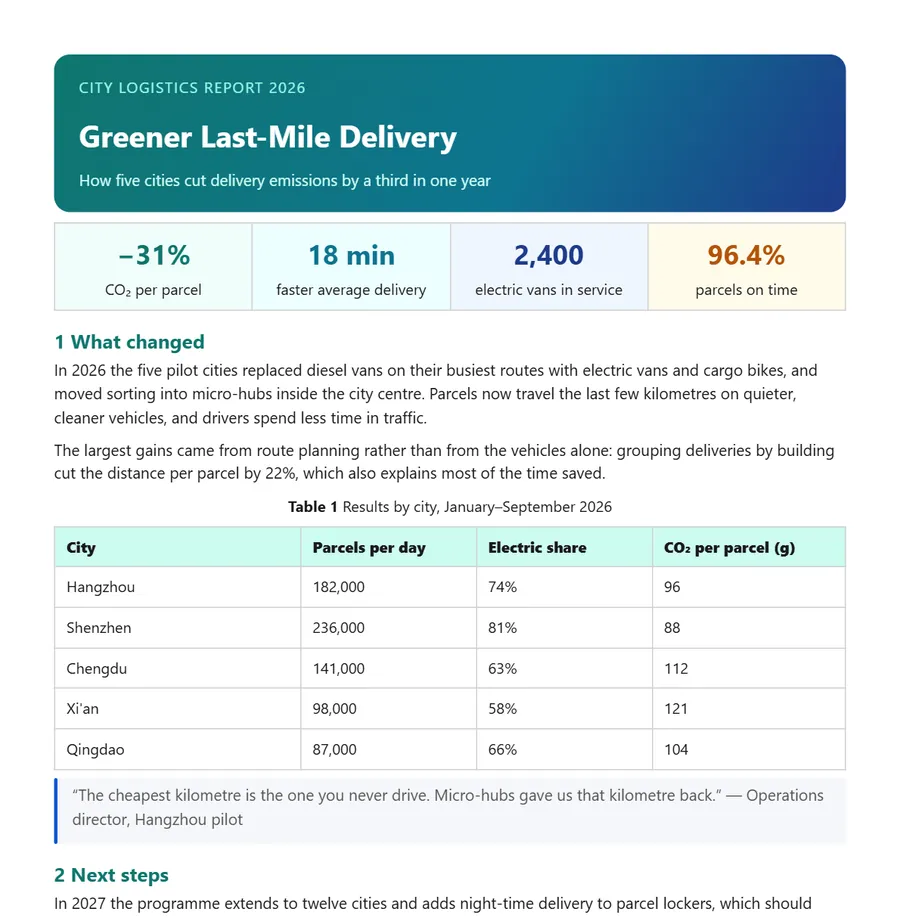
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
다운로드하시는 ZIP 파일에는 다음과 같은 내용이 포함되어 있습니다
document.md전체 텍스트는 Markdowndocument.json읽기 순서로 구조화된 데이터images/문서에 있는 사진들manifest.json기본 정보가 포함된 파일 목록
지원되는 형식
| 파일 | 처리 방법 |
|---|---|
| PDF, 스캔된 PDF, PNG, JPG, WEBP 및 BMP 이미지 | 레이아웃 분석, 텍스트 인식(OCR) 및 테이블 인식 |
| Word、PowerPoint、Excel、CSV | 문서 구조를 직접 읽습니다. |
| EPUB 전자책, HTML 페이지 | 장과 본문은 분석됩니다 |
| Markdown, TXT, SRT, ASS 자막 | 동일한 Markdown 및 JSON로 변환됨 |
질문
결과물에는 어떤 파일이 포함되어 있나요?
document.md(전체 텍스트는 Markdown), document.json(구조화된 데이터), images/(사진), manifest.json(파일 목록)가 포함된 ZIP 파일 하나.
스캔 결과는 추출할 수 있나요?
네. 스캔된 PDF 파일과 이미지가 먼저 인식되고 그 다음에 정리됩니다. 인식된 텍스트를 원본과 대조해 보세요, 특히 숫자와 표를 확인하세요.
무료 추출의 한계는 무엇입니까?
PDF당 최대 501페이지이며 월별 한도는 없습니다. 무료 추출은 제출된 순서대로 처리되므로 속도는 대기열에 따라 다릅니다. 우리는 품질에 최선을 다합니다. 결과가 충분하지 않은 경우에는 양해해 주시기 바랍니다. 대용량 파일의 경우 또는 급한 경우 페이지 제한 및 대기열이 없는 OmniDoc 데스크톱 앱을 권장합니다.
이것은 텍스트를 복사하는 것과 어떻게 다른가요?
추출은 제목 수준, 단락, 표, 이미지와 이들이 어떻게 연관되어 있는지 유지해서 일반 텍스트가 아닌 구조화된 데이터를 얻을 수 있습니다.
계정이 필요한가요?
예. OmniDoc 계정으로 로그인하세요. 가입은 무료입니다. 귀하만이 업로드한 파일과 그 결과를 볼 수 있습니다.
결과는 어디서 다운로드하나요?
준비가 되면 이 페이지에서 다운로드하세요. 추출은 백그라운드에서 실행되므로 페이지를 떠나는 것은 영향을 주지 않습니다; 이 페이지를 다시 열고 로그인하여 "최근 추출"에서 이전 파일을 찾으세요.
파일 확장자가 실제 형식과 일치하지 않으면 어떻게 되나요?
실제 형식은 파일 내용에서 감지됩니다. 예를 들어 실제로는 Word 문서인 .pdf 파일은 .docx으로 처리되고 .docx로 반환됩니다. 먼저 이전 .doc, .xls 및 .ppt 파일을 .docx, .xlsx 및 .pptx로 저장하세요.
설치해야 할 것이 있나요?
아니요, 브라우저에서 실행됩니다. 페이지가 많거나 급할 때는 Windows, macOS, Linux용 OmniDoc 데스크톱 앱을 추천합니다: 페이지 제한도 없고 대기열도 없습니다.
OmniDoc 데스크톱 앱: 원활한 100% Office XML 지원, 중국의 새로운 국가 표준
Windows, macOS, Linux용 무료 데스크톱 앱은 사용자의 컴퓨터에서 파일을 열고, 편집하며, 저장할 수 있습니다.