
Extragere gratuită a documentelor
Extrageți titlurile, paragrafele, tabelele și imaginile fișierelor PDF, scanărilor, fișierelor Word, PowerPoint și Excel în Markdown și JSON.
Până la 501 pagini per PDF și fără limită lunară; extracțiile gratuite așteaptă într-o coadă. Pentru fișiere mari sau când vă grăbiți, vă recomandămaplicația desktop OmniDoc: fără limită de pagini și fără coadă.
Cum se transformă un PDF în Markdown și JSON
- 1Încărcați fișierulConectați-vă cu un cont OmniDoc, apoi aruncați fișierul în zona de mai sus sau faceți clic pe „Alegeți fișierul”.
- 2Începeți extracțiaFișierele, scanările și imaginile PDF trec prin analiza aspectului, recunoașterea textului și recunoașterea tabelului; Fișierele Word, PowerPoint și Excel, cărțile electronice și paginile web sunt analizate direct.
- 3Descărcați rezultatulCând ați terminat, descărcați un fișier ZIP cu Markdown, JSON și imagini.
Exemplu
Pagina 1 a unui raport și Markdown extras din acesta: se păstrează nivelurile de titlu, paragrafele și tabelele.
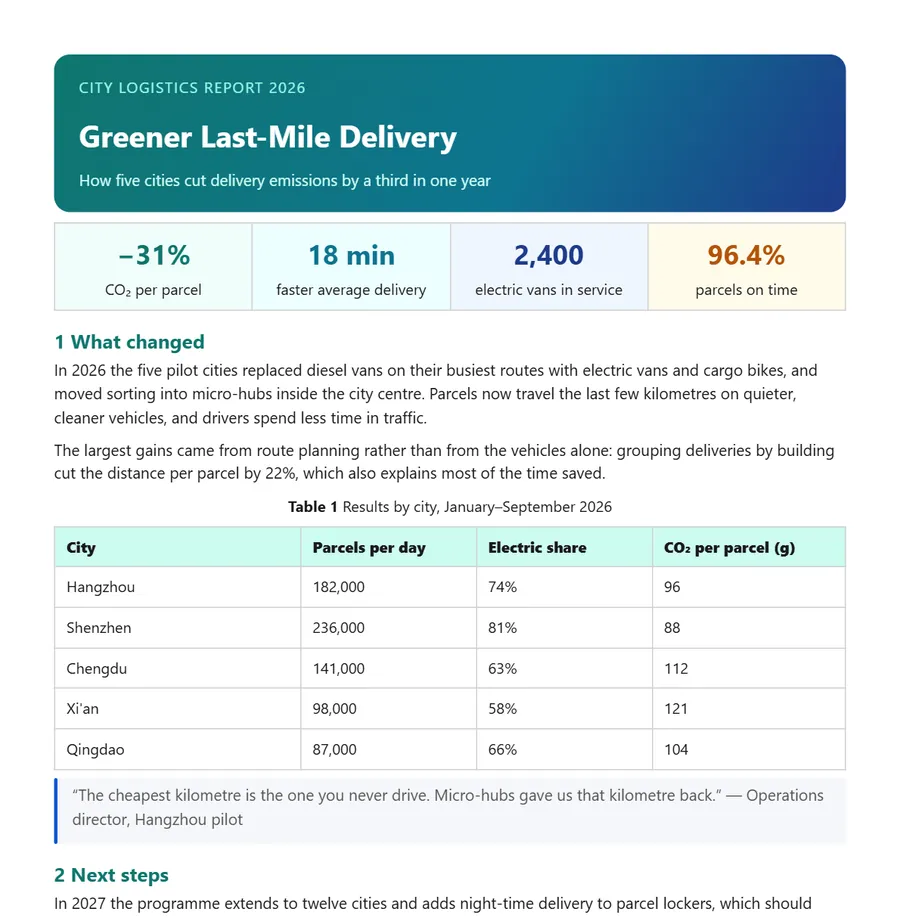
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
Fișierul ZIP pe care îl descărcați conține
document.mdTextul complet ca Markdowndocument.jsonDate structurate în ordinea de citireimages/Imaginile din documentmanifest.jsonO listă a fișierelor cu informații de bază
Formate acceptate
| Fișier | Cum este procesat |
|---|---|
| PDF, imagini scanate PDF, PNG, JPG, WEBP și BMP | Analiza aspectului, recunoașterea textului (OCR) și recunoașterea tabelelor |
| Word、PowerPoint、Excel、CSV | Structura documentului este citită direct |
| Cărți electronice EPUB, pagini HTML | Capitolele și textul corpului sunt analizate |
| Subtitrări Markdown, TXT, SRT și ASS | Convertit în aceleași Markdown și JSON |
Întrebări
Ce fișiere conține rezultatul?
Un fișier ZIP cu document.md (textul complet ca Markdown), document.json (date structurate), images/ (imaginile) și manifest.json (o listă a fișierelor).
Pot fi extrase scanările?
Da. Fișierele și imaginile scanate PDF sunt recunoscute mai întâi și apoi organizate. Verificați textul recunoscut față de original, în special numere și tabele.
Care sunt limitele extracției gratuite?
Până la 501 de pagini per PDF și fără limită lunară. Extracțiile gratuite sunt procesate în ordinea în care sunt depuse, deci viteza depinde de coadă. Facem tot posibilul pentru calitate; dacă un rezultat nu este suficient de bun, vă rugăm să aveți grijă de noi. Pentru fișiere mari sau când vă grăbiți, vă recomandăm aplicația pentru desktop OmniDoc: fără limită de pagini și fără coadă.
Cum este aceasta diferită de copierea textului?
Extragerea păstrează nivelurile de titlu, paragrafele, tabelele și imaginile și modul în care acestea se raportează, astfel încât să obțineți date structurate mai degrabă decât text simplu.
Am nevoie de un cont?
Da. Autentifică-te cu un cont OmniDoc; Înscrierea este gratuită. Doar tu poți vedea fișierele pe care le încarci și rezultatele lor.
Unde descarc rezultatul?
Descărcați-l pe această pagină când este gata. Extragerea rulează în fundal, așa că părăsirea paginii nu o afectează; deschideți din nou această pagină și conectați-vă pentru a găsi fișiere anterioare în „Extractii recente”.
Ce se întâmplă dacă extensia fișierului nu se potrivește cu formatul real?
Formatul real este detectat din conținutul fișierului. De exemplu, un fișier .pdf care este de fapt un document Word este procesat ca .docx și revine ca .docx. Salvați mai întâi fișierele vechi .doc, .xls și .ppt ca .docx, .xlsx și .pptx.
Trebuie să instalez ceva?
Nu, rulează în browser. Pentru fișiere cu multe pagini sau când ești grăbit, recomandăm aplicația desktop OmniDoc pentru Windows, macOS și Linux: fără limită de pagini și fără coadă.
Aplicația desktop OmniDoc: fluidă, suport 100% Office XML, noile standarde naționale ale Chinei
Aplicația desktop gratuită pentru Windows, macOS și Linux deschide, editează și salvează fișiere pe propriul tău calculator.