
Extrahování dokumentů zdarma
Extrahujte nadpisy, odstavce, tabulky a obrázky souborů PDF, skenů, souborů Word, PowerPoint a Excel do Markdown a JSON.
Až 501 stránek na PDF a žádný měsíční limit; bezplatné extrakce čekají ve frontě. Pro velké soubory nebo když spěcháte, doporučujemedesktopovou aplikaci OmniDoc: žádný limit stránek a žádná fronta.
Jak převést PDF na Markdown a JSON
- 1Nahrajte souborPřihlaste se pomocí účtu OmniDoc a poté přetáhněte soubor do oblasti výše nebo klikněte na „Vybrat soubor“.
- 2Začněte extrakciPDF soubory, skeny a obrázky procházejí analýzou rozvržení, rozpoznáváním textu a rozpoznáváním tabulek; Soubory, e-knihy a webové stránky Word, PowerPoint a Excel jsou analyzovány přímo.
- 3Stáhněte si výsledekAž budete hotovi, stáhněte si soubor ZIP s Markdown, JSON a obrázky.
Příklad
Stránka 1 zprávy a Markdown z ní vyextrahované: úrovně nadpisů, odstavce a tabulky jsou uchovávány.
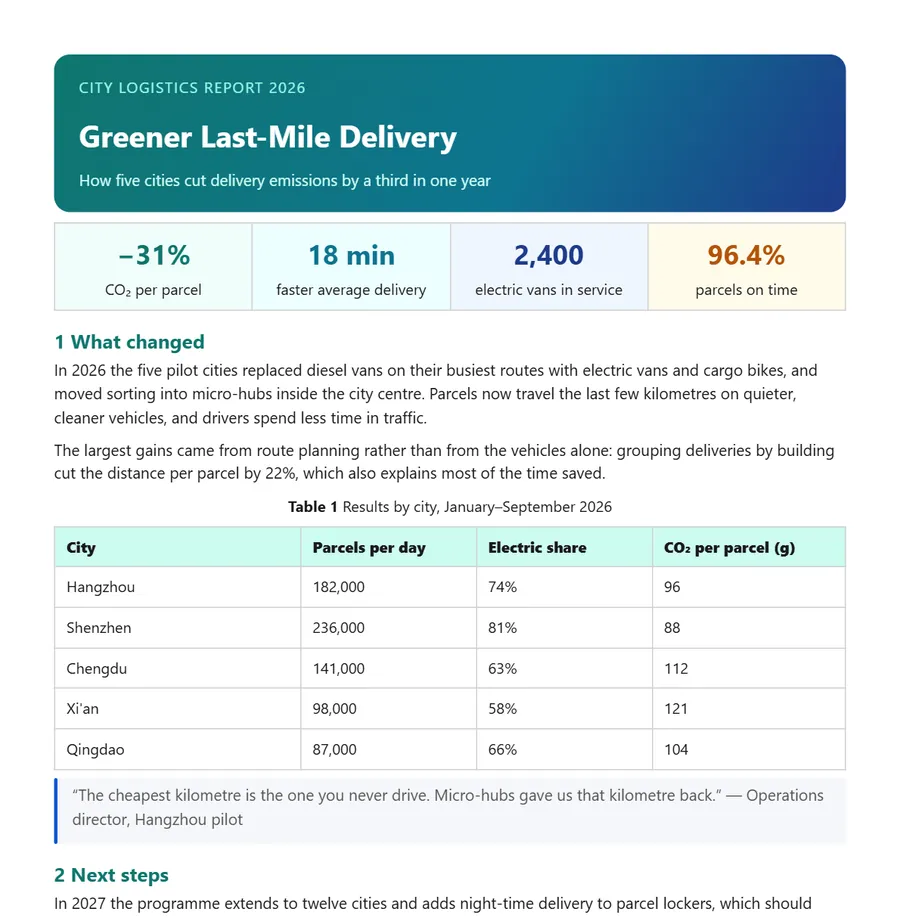
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
Stažený soubor ZIP obsahuje
document.mdCelý text jako Markdowndocument.jsonStrukturovaná data v pořadí čteníimages/Obrázky v dokumentumanifest.jsonSeznam souborů se základními informacemi
Podporované formáty
| Soubor | Jak se zpracovává |
|---|---|
| PDF, skenované PDF, PNG, JPG, WEBP a BMP | Analýza rozložení, rozpoznávání textu (OCR) a rozpoznávání tabulek |
| Word、PowerPoint、Excel、CSV | Struktura dokumentu se čte přímo |
| EPUB e-knihy, HTML stránky | Kapitoly a hlavní text jsou analyzovány |
| Markdown, TXT, SRT a ASS titulky | Převedeno na stejné Markdown a JSON |
Otázky
Jaké soubory výsledek obsahuje?
Jeden soubor ZIP s document.md (úplný text jako Markdown), document.json (strukturovaná data), images/ (obrázky) a manifest.json (seznam souborů).
Lze snímky extrahovat?
Ano. Naskenované soubory a obrázky PDF jsou nejprve rozpoznány a poté uspořádány. Zkontrolujte rozpoznaný text oproti originálu, zejména čísla a tabulky.
Jaké jsou hranice bezplatné extrakce?
Až 501 stran na PDF a žádný měsíční limit. Bezplatné extrakce se zpracovávají v pořadí, v jakém jsou odeslány, takže rychlost závisí na frontě. Děláme maximum pro kvalitu; Pokud výsledek nebude dostatečně dobrý, prosím, mějte s námi trpělivost. Pro velké soubory nebo když spěcháte, doporučujeme desktopovou aplikaci OmniDoc: žádný limit stránek a žádná fronta.
Jak se to liší od kopírování textu?
Extrakce zachovává úrovně nadpisů, odstavců, tabulek a obrázků a jejich vztah, takže získáte spíše strukturovaná data než prostý text.
Potřebuji účet?
Ano. Přihlaste se pomocí účtu OmniDoc; registrace je zdarma. Soubory, které nahrajete, a jejich výsledky vidíte pouze vy.
Kde si mohu stáhnout výsledek?
Až bude připraven, stáhněte si ji na této stránce. Extrakce probíhá na pozadí, takže opuštění stránky na to nemá vliv; znovu otevřete tuto stránku a přihlaste se, abyste našli dřívější soubory v části „Poslední extrakce“.
Co když přípona souboru neodpovídá skutečnému formátu?
Skutečný formát je rozpoznán z obsahu souboru. Například .pdf soubor, který je ve skutečnosti dokumentem Word, je zpracován jako .docx a vrátí se jako .docx. Nejprve uložte staré soubory .doc, .xls a .ppt jako .docx, .xlsx a .pptx.
Musím něco instalovat?
Ne, běží to v prohlížeči. Pro soubory s mnoha stránkami nebo když spěcháte, doporučujeme desktopovou aplikaci OmniDoc pro Windows, macOS a Linux: žádný limit stránek a žádná fronta.
Desktopová aplikace OmniDoc: hladká, 100% podpora Office XML, nové čínské národní standardy
Bezplatná desktopová aplikace pro Windows, macOS a Linux otevírá, upravuje a ukládá soubory na vašem vlastním počítači.