 OmniDoc
?怎么把 PDF 免费转成 Markdown 和 JSON?
打开本页,登录 OmniDoc 账号,把文件拖进上面的框,点「开始免费提取」。PDF、扫描件和图片会做版面识别、文字识别和表格识别;Word、PPT、Excel、电子书和网页直接解析文档结构。
完成后下载一个 ZIP:document.md 是整篇 Markdown,document.json 是结构化数据,images/ 是文档里的图片。免费提取由 OmniDoc 出资,不扣账户积分。
文档结构化提取:4 步完成
不用装软件,不用会排版,四步拿到结果。
- 1上传文件把 PDF、扫描件、Word、PPT 等文件拖进上传框,或点「点击选择文件」。
- 2自动选择提取方式PDF 和图片走版面识别 + OCR;Office、电子书、网页直接解析。
- 3点「开始免费提取」进入免费队列,处理完成会在页面上提示。
- 4下载提取结果下载 ZIP:Markdown、JSON 和图片都在里面。
提取效果演示
同一页报告,提取后标题层级、段落和表格都变成可以直接用的 Markdown。
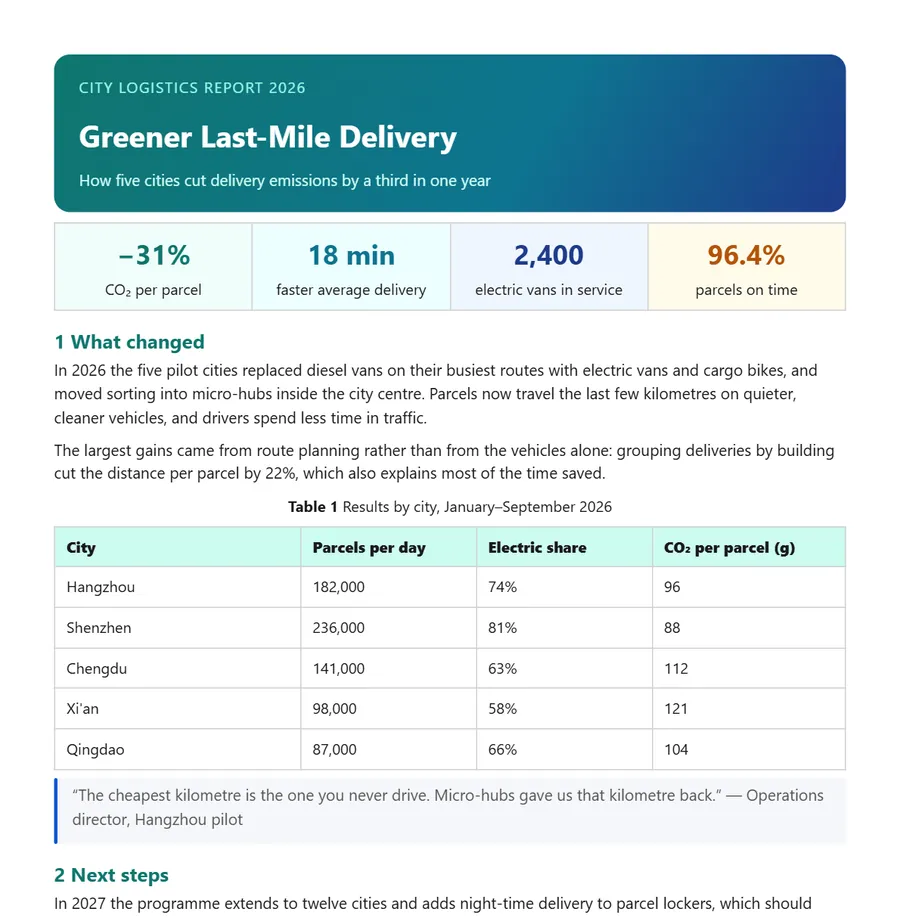
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
示例:英文城市物流报告第 1 页 → document.md(节选)
document.md整篇 Markdowndocument.json结构化数据images/文档里的图片manifest.json文件清单
提取结果里有什么
完成后在本页直接下载,离开页面也会保存在你的账号里。
支持哪些文件
常见的办公文档、电子书、网页和图片都能直接上传。
| 文件 | 提取方式 |
|---|---|
| PDF、扫描件 PDF、PNG / JPG / WEBP / BMP 图片 | 版面识别 + 文字识别(OCR)+ 表格识别 |
| Word、PPT、Excel、CSV | 直接解析文档结构 |
| EPUB 电子书、HTML 网页 | 解析章节和正文结构 |
| Markdown、TXT、SRT / ASS 字幕 | 整理成统一的 Markdown 和 JSON |
安全保障与使用场景
结果只属于你,适合日常学习和工作里的这些场景。
文件与结果
- 登录后使用,结果只有你本人能看到
- 由 OmniDoc 出资,不扣账户积分
- 识别结果请对照原文核对数字和表格
常见使用场景
- 导入知识库和检索系统
- 给 AI 助手准备资料
- 扫描合同、票据归档成文字
- 报表里的表格转成数据
- 论文、讲义转成 Markdown 笔记
常见问题
提取结果是什么格式?
一个 ZIP 包:document.md(Markdown 全文)、document.json(结构化数据)、images/(图片)和 manifest.json(清单)。
扫描件能提取吗?
可以。PDF 扫描件和图片会先做文字识别再整理结构。识别结果请对照原文核对,尤其是数字和表格。
一个文件最多多少页?
PDF 单个文件最多 501 页,文件大小上限以本页显示为准。更长的文件可以拆开分次提交。
和普通「复制粘贴」有什么不同?
提取会保留标题层级、段落、表格和图片的关系,得到的是有结构的数据,而不只是一串文字。
需要登录吗?
需要。用 OmniDoc 账号登录后即可使用,注册免费。登录是为了把结果只留给你本人,并让每个人公平排队。
真的不扣积分吗?
不扣。免费工具由 OmniDoc 出资,提交后排队处理,账户里的积分不会减少。每天有免费名额,用完后已提交的文件照常完成,第二天可以再来。
结果谁能看到?
只有提交人本人。处理完成后在本页下载,离开页面也没关系,回来登录后还能在「最近的」列表里看到。
为什么有时要排队?
免费队列全站每分钟最多开始处理 3000 页 PDF,翻译和提取分开计算。人多的时候文件按顺序排队,轮到你会自动开始,不用一直守着页面。
文件后缀名不对也能处理吗?
能。上传时会按文件内容识别真实格式,比如其实是 Word 的 .pdf、其实是 Excel 的 .csv,会自动改成正确的后缀再处理,结果也按真实格式返回。旧版 .doc / .xls / .ppt 请先另存为新格式。
需要安装软件吗?
不需要,浏览器打开本页即可。需要在本机处理文件,也可以下载 OmniDoc 桌面客户端(Windows、macOS、Linux)。
更多工具
同一个 OmniDoc 账号都能用。