
無料の文書抽出
PDF ファイル、スキャン、Word、PowerPoint、および Excel ファイルの見出し、段落、表、画像を Markdown と JSON に抽出します。
PDFあたり最大501ページまで、月間上限はありません。無料の抽出は列に並んで待っています。大きなファイルや急いでいる場合には、おすすめしますOmniDoc デスクトップ アプリ: ページ制限なし、キューなし。
PDF を Markdown および JSON に変換する方法
- 1ファイルをアップロードしてくださいOmniDoc アカウントでサインインし、上の領域にファイルをドロップするか、[ファイルを選択] をクリックします。
- 2抽出を開始しますPDFファイル、スキャン、画像はレイアウト解析、テキスト認識、テーブル認識を経て、Word、PowerPoint、Excelのファイル、電子書籍、ウェブページは直接解析されます。
- 3結果をダウンロードするそれが完了したら、Markdown、JSON、および画像を含む ZIP ファイルをダウンロードします。
例
レポートの 1 ページ目とそこから抽出された Markdown: 見出しレベル、段落、表が保持されます。
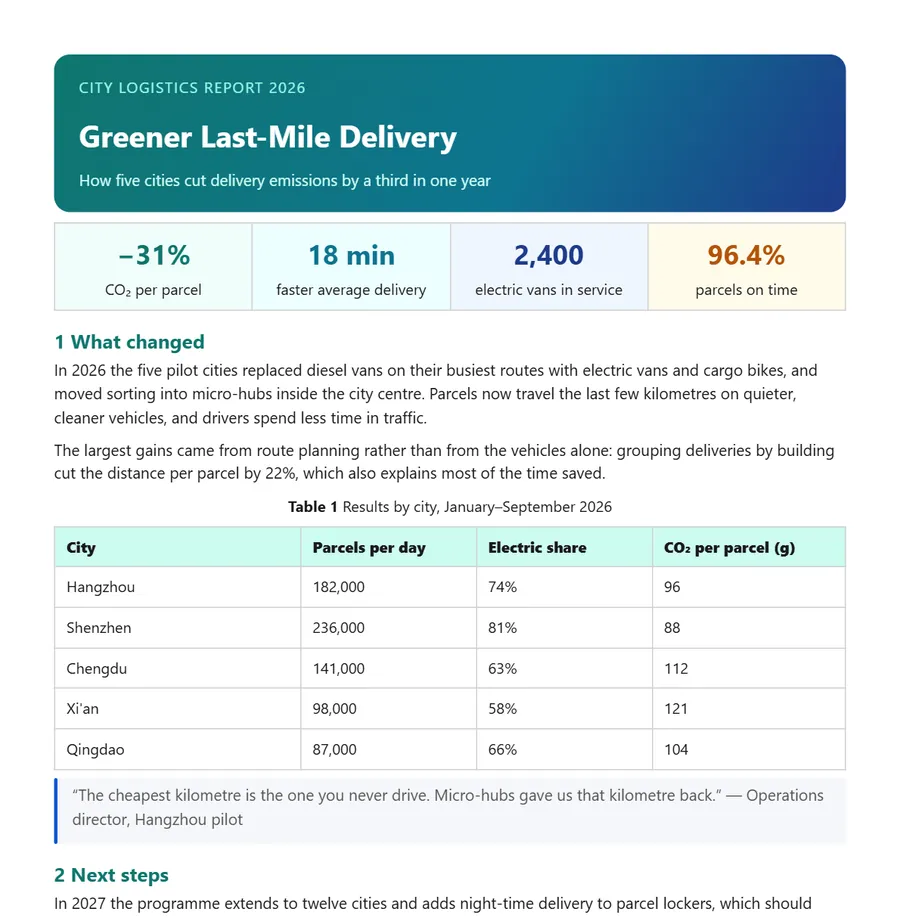
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
ダウンロードするZIPファイルには以下が含まれています
document.md全文はMarkdowndocument.json読み込み順の構造化データimages/文書内の写真manifest.json基本情報を含むファイルの一覧
サポートされている形式
| ファイル | 処理方法 |
|---|---|
| PDF、スキャンされたPDF、PNG、JPG、WEBP、BMPの画像 | レイアウト解析、テキスト認識(OCR)、表認識 |
| Word、PowerPoint、Excel、CSV | 文書構造は直接読み取られます |
| EPUB 電子書籍、HTML ページ | 章と本文が解析されます |
| Markdown、TXT、SRT、ASS 字幕 | 同じMarkdownとJSONに変換 |
質問
結果にはどのファイルが含まれますか?
ZIPファイル1つで、document.md(全文はMarkdown)、document.json(構造化データ)、images/(画像)、manifest.json(ファイル一覧)が入っています。
スキャンは抽出できますか?
はい。スキャンされた PDF ファイルと画像は、最初に認識されてから整理されます。認識されたテキスト、特に数字や表をオリジナルと比較して確認します。
無料抽出の制限は何ですか?
PDF あたり最大 501 ページで、月間上限はありません。無料抽出は送信された順に処理されるため、速度はキューによって異なります。私たちは品質に関して最善を尽くします。結果が十分ではない場合は、ご容赦ください。大きなファイルの場合、または急いでいる場合は、ページ制限やキューがない OmniDoc デスクトップ アプリをお勧めします。
これはテキストをコピーすることとどう違うのですか?
抽出では見出しレベル、段落、表、画像とそれらの関係が保持されるため、プレーン テキストではなく構造化データが得られます。
アカウントは必要ですか?
はい。 OmniDoc アカウントでサインインします。サインアップは無料です。アップロードしたファイルとその結果を見ることができるのは自分だけです。
結果はどこからダウンロードすればよいですか?
準備ができたらこのページでダウンロードしてください。抽出はバックグラウンドで動作するため、ページを離れても影響しません。このページを再度開いてサインインすると、「最近の抽出」欄で以前のファイルを見つけてください。
もしファイル拡張子が実際のフォーマットと一致しなかったらどうしますか?
実際のフォーマットはファイルの内容から検出されます。例えば、実際にはWordのドキュメントである.pdfファイルは.docxとして処理され、.docxとして戻ってきます。古い.doc、.xls、.pptファイルをまず.docx、.xlsx、.pptxとして保存してください。
何かインストールする必要がありますか?
いいえ、ブラウザ内で実行されます。ページ数が多いファイルの場合、または急いでいる場合は、Windows、macOS、Linux 用の OmniDoc デスクトップ アプリをお勧めします。ページ制限やキューはありません。
OmniDoc デスクトップ アプリ: スムーズな 100% Office XML サポート、中国の新しい国家標準
Windows、macOS、Linuxの無料デスクトップアプリは、自分のパソコン上でファイルを開いたり編集したり保存したりできます。