
Бесплатное извлечение документов
Извлеките заголовки, абзацы, таблицы и изображения файлов PDF, сканов, файлов Word, PowerPoint и Excel в Markdown и JSON.
До 501 страницы на PDF без ежемесячного ограничения; бесплатные извлечения ждут в очереди. Для больших файлов или когда вы спешите, мы рекомендуемдесктопное приложение OmniDoc: нет ограничения по странице и нет очереди.
Как преобразовать PDF в Markdown и JSON
- 1Загрузить файлВойдите с аккаунтом OmniDoc, затем поместите файл в область выше или нажмите «Выбрать файл».
- 2Начать извлечениеФайлы, сканы и изображения PDF проходят анализ макета, распознавание текста и таблицы; Файлы Word, PowerPoint и Excel, электронные книги и веб-страницы анализируются напрямую.
- 3Скачать результатКогда это будет сделано, загрузите файл ZIP с Markdown, JSON и изображениями.
Пример
Страница 1 отчёта и извлеченный из него Markdown: уровни заголовков, абзацы и таблицы сохраняются.
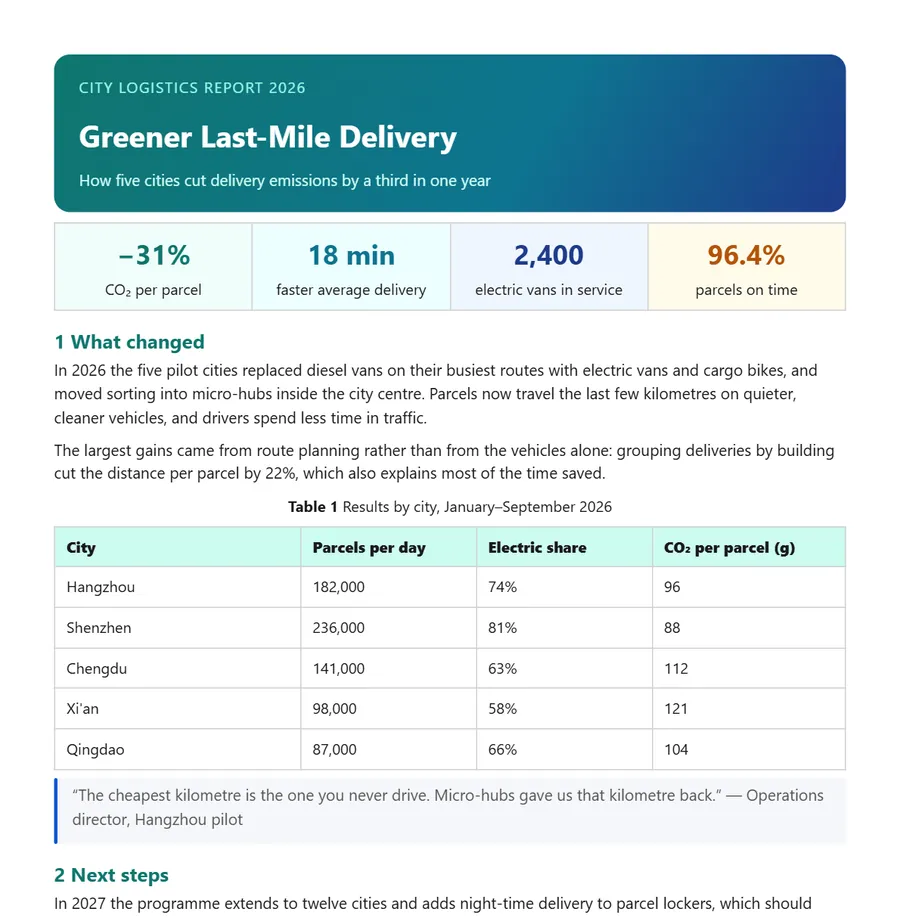
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
Загруженный вами файл ZIP содержит
document.mdПолный текст как Markdowndocument.jsonСтруктурированные данные в порядке чтенияimages/Фотографии в документеmanifest.jsonСписок файлов с базовой информацией
Поддерживаемые форматы
| Файл | Как это обрабатывается |
|---|---|
| PDF, отсканированные изображения PDF, PNG, JPG, WEBP и BMP | Анализ макета, распознавание текста (OCR) и распознавание таблиц |
| Word、PowerPoint、Excel、CSV | Структура документа читается напрямую |
| Электронные книги: EPUB, страниц: HTML | Главы и основной текст анализируются |
| Markdown, TXT, SRT и ASS субтитры | Преобразовано в те же Markdown и JSON |
Вопросы
Какие файлы содержит результат?
Один файл ZIP с document.md (полный текст в виде Markdown), document.json (структурированные данные), images/ (изображения) и manifest.json (список файлов).
Можно ли извлечь сканы?
Да. Отсканированные файлы и изображения PDF сначала распознаются, а затем систематизируются. Сравните распознанный текст с оригиналом, особенно цифры и таблицы.
Каковы пределы бесплатного извлечения?
До 501 страницы на PDF без ежемесячного ограничения. Бесплатные извлечения обрабатываются в порядке их отправки, поэтому скорость зависит от очереди. Мы делаем все возможное для качества; если результат недостаточно хорош, пожалуйста, поддержите нас. Для больших файлов или когда вы спешите, мы рекомендуем настольное приложение OmniDoc: без ограничений по количеству страниц и без очереди.
Чем это отличается от копирования текста?
Извлечение сохраняет уровни заголовков, абзацы, таблицы и изображения и их связь, так что вы получаете структурированные данные, а не простой текст.
Нужен ли мне аккаунт?
Да. Войдите в систему с учетной записью OmniDoc; регистрация бесплатна. Только вы можете видеть загружаемые вами файлы и их результаты.
Где скачать результат?
Загрузите его на этой странице, когда он будет готов. Извлечение выполняется в фоновом режиме, поэтому выход из страницы не влияет на него; откройте эту страницу еще раз и войдите в систему, чтобы найти более ранние файлы в разделе «Недавние извлечения».
Что если расширение файла не совпадает с настоящим форматом?
Реальный формат определяется по содержимому файла. Например, .pdf-файл, который на самом деле является документом Word, обрабатывается как .docx и возвращается как .docx. Сначала сохраняйте старые файлы .doc, .xls и .ppt как .docx, .xlsx и .pptx.
Нужно ли что-то устанавливать?
Нет, он работает в браузере. Для файлов с большим количеством страниц или когда вы спешите, мы рекомендуем приложение OmniDoc для Windows, macOS и Linux: нет ограничения по странице и нет очереди.
Десктопное приложение OmniDoc: плавная, 100% поддержка Office XML, новые национальные стандарты Китая
Бесплатное десктопное приложение для Windows, macOS и Linux открывает, редактирует и сохраняет файлы на вашем собственном компьютере.