
Extraction gratuite de documents
Extraire les titres, paragraphes, tableaux et images des fichiers PDF, scans, fichiers Word, PowerPoint et Excel en Markdown et JSON.
Jusqu’à 501 pages par PDF sans plafond mensuel ; Les extractions gratuites attendent en file d’attente. Pour les gros dossiers ou lorsque vous êtes pressé, nous recommandonsl’application de bureau OmniDoc: pas de limite de pages et pas de file d'attente.
Comment convertir un PDF en Markdown et JSON
- 1Téléchargez le fichierConnectez-vous avec un compte OmniDoc, puis déposez le fichier dans la zone ci-dessus ou cliquez sur « Choisir le fichier ».
- 2Commencez l’extractionLes fichiers, scans et images PDF passent par l’analyse de la mise en page, la reconnaissance de texte et la reconnaissance de tables ; Les fichiers, e-books et pages web Word, PowerPoint et Excel sont analysés directement.
- 3Téléchargez le résultatLorsque c'est fait, téléchargez un fichier ZIP avec le Markdown, le JSON et les images.
Exemple
Page 1 d’un rapport et le Markdown extrait de celui-ci : les niveaux de titre, les paragraphes et les tableaux sont conservés.
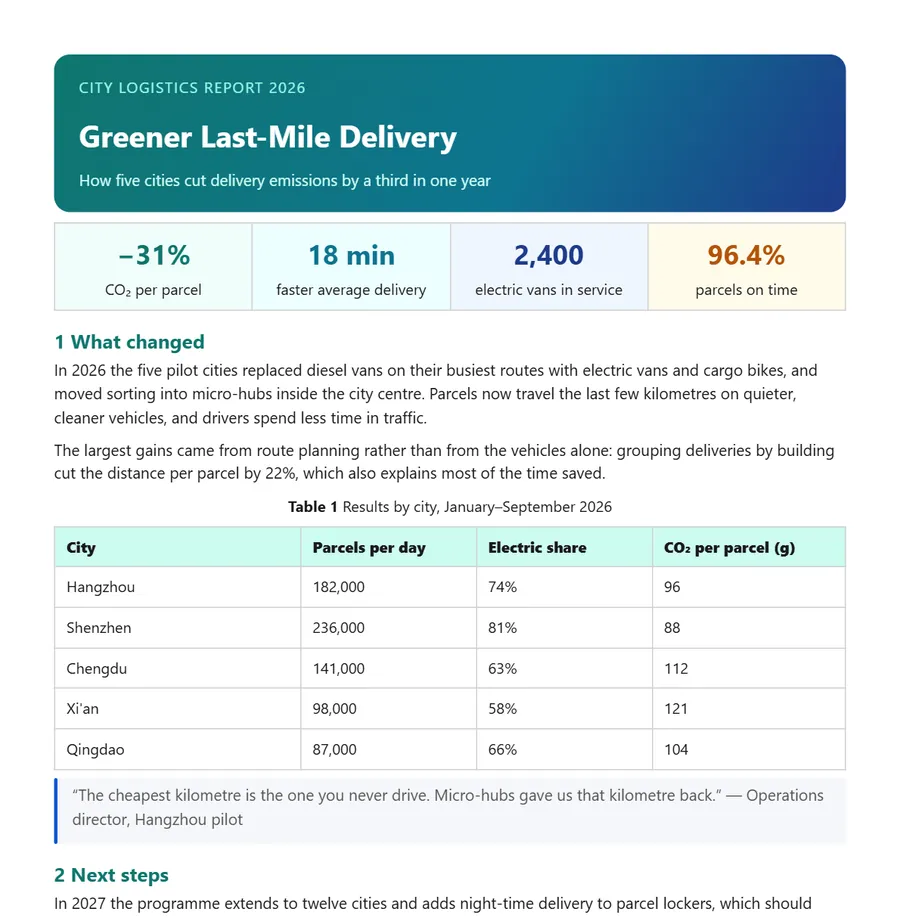
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
Le fichier ZIP que vous téléchargez contient
document.mdLe texte intégral sous forme de Markdowndocument.jsonDonnées structurées dans l’ordre de lectureimages/Les photos dans le documentmanifest.jsonUne liste des fichiers avec des informations de base
Formats pris en charge
| Fichier | Comment c’est traité |
|---|---|
| PDF, images numérisées PDF, PNG, JPG, WEBP et BMP | Analyse de mise en page, reconnaissance de texte (OCR) et reconnaissance de tableaux |
| Word、PowerPoint、Excel、CSV | La structure du document est lue directement |
| EPUB livres électroniques, HTML pages | Les chapitres et le texte du corps sont analysés |
| Sous-titres Markdown, TXT, SRT et ASS | Converti en les mêmes Markdown et JSON |
Questions
Quels fichiers le résultat contient-il ?
Un fichier ZIP avec document.md (le texte intégral sous la forme Markdown), document.json (les données structurées), images/ (les images) et manifest.json (une liste des fichiers).
Les scans peuvent-ils être extraits ?
Oui. Les fichiers et images PDF numérisés sont d’abord reconnus puis organisés. Vérifiez le texte reconnu par rapport à l’original, en particulier les chiffres et les tableaux.
Quelles sont les limites de l’extraction gratuite ?
Jusqu’à 501 pages par PDF et sans plafond mensuel. Les extractions gratuites sont traitées dans l’ordre de leur soumission, donc la rapidité dépend de la file d’attente. Nous faisons de notre mieux pour la qualité ; Si un résultat n’est pas suffisant, merci de votre patience. Pour les fichiers volumineux ou lorsque vous êtes pressé, nous recommandons l’application de bureau OmniDoc : pas de limite de pages et pas de file d’attente.
En quoi est-ce différent de copier le texte ?
L’extraction conserve les niveaux de titres, paragraphes, tableaux et images ainsi que leur relation, ce qui permet d’obtenir des données structurées plutôt que du texte brut.
Ai-je besoin d'un compte ?
Oui. Connectez-vous avec un compte OmniDoc ; L’inscription est gratuite. Vous seul pouvez voir les fichiers que vous téléchargez et leurs résultats.
Où puis-je télécharger le résultat ?
Téléchargez-le sur cette page dès qu’il sera prêt. L’extraction s’exécute en arrière-plan, donc quitter la page ne l’affecte pas ; ouvrez à nouveau cette page et connectez-vous pour trouver les fichiers précédents sous « Extractions récentes ».
Que faire si l'extension du fichier ne correspond pas au format réel ?
Le format réel est détecté à partir du contenu du fichier. Par exemple, un fichier .pdf qui est en réalité un document Word est traité comme .docx et revient comme .docx. Enregistrez d'abord les anciens fichiers .doc, .xls et .ppt sous .docx, .xlsx et .pptx.
Dois-je installer quelque chose ?
Non, cela fonctionne dans le navigateur. Pour les fichiers comportant de nombreuses pages ou lorsque vous êtes pressé, nous vous recommandons l'application de bureau OmniDoc pour Windows, macOS et Linux : aucune limite de pages et aucune file d'attente.
L'application de bureau OmniDoc : prise en charge fluide et 100 % d'Office XML, nouvelles normes nationales chinoises
L'application de bureau gratuite pour Windows, macOS et Linux ouvre, modifie et enregistre les fichiers sur votre propre ordinateur.