
Estrazione gratuita dei documenti
Estrarre i titoli, i paragrafi, le tabelle e le immagini dei file PDF, scansioni, file Word, PowerPoint e Excel in Markdown e JSON.
Fino a 501 pagine per PDF e senza limite mensile; Le estrazioni gratuite aspettano in coda. Per file grandi o quando hai fretta, lo consigliamol'app desktop OmniDoc: nessun limite di pagine e nessuna coda.
Come convertire un PDF in Markdown e JSON
- 1Carica il fileAccedi con un account OmniDoc, poi inserisci il file nell'area sopra o clicca su "Scegli file".
- 2Inizia l'estrazioneFile PDF vengono sottoposti ad analisi del layout, riconoscimento del testo e riconoscimento delle tabelle; Word, PowerPoint e Excel, e-book e pagine web vengono analizzati direttamente.
- 3Scarica il risultatoAl termine, scarica un file ZIP con Markdown, JSON e le immagini.
Esempio
Pagina 1 di un rapporto e il Markdown estratto da esso: vengono mantenuti livelli di intestazione, paragrafi e tabelle.
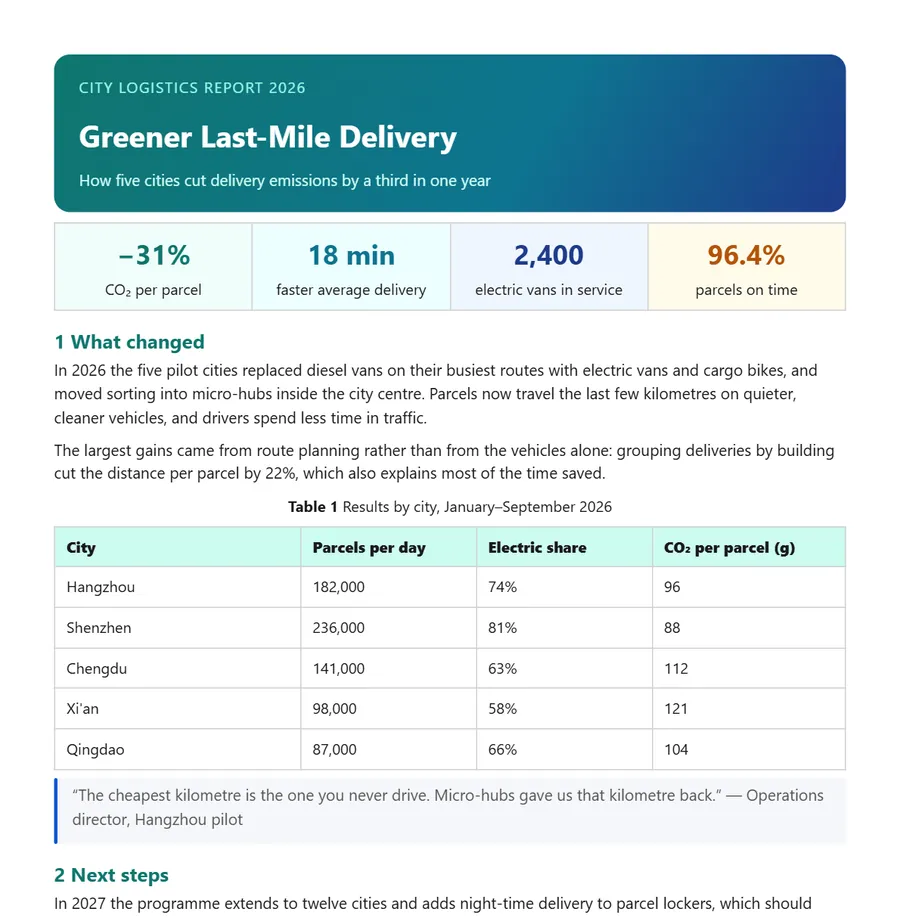
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
Il file ZIP scaricato contiene
document.mdIl testo completo come Markdowndocument.jsonDati strutturati in ordine di letturaimages/Le foto nel documentomanifest.jsonUn elenco dei file con le informazioni di base
Formati supportati
| File | Come viene elaborato |
|---|---|
| Immagini PDF, scansionate PDF, PNG, JPG, WEBP e BMP | Analisi del layout, riconoscimento del testo (OCR) e riconoscimento delle tabelle |
| Word、PowerPoint、Excel、CSV | La struttura del documento viene letta direttamente |
| EPUB e-book, HTML pagine | I capitoli e il testo del corpo sono analizzati |
| Sottotitoli Markdown, TXT, SRT e ASS | Convertito nello stesso Markdown e JSON |
Domande
Quali file contiene il risultato?
Un file ZIP con document.md (il testo completo come Markdown), document.json (dati strutturati), images/ (le immagini) e manifest.json (un elenco dei file).
È possibile estrarre le scansioni?
SÌ. I file e le immagini PDF scansionati vengono prima riconosciuti e poi organizzati. Confronta il testo riconosciuto con l'originale, in particolare numeri e tabelle.
Quali sono i limiti dell’estrazione gratuita?
Fino a 501 pagine per PDF e nessun limite mensile. Le estrazioni gratuite vengono processate nell'ordine in cui vengono inviate, quindi la velocità dipende dalla coda. Facciamo del nostro meglio per la qualità; Se un risultato non è sufficiente, vi invitiamo a avere pazienza. Per file grandi o quando hai fretta, consigliamo l'app desktop OmniDoc: nessun limite di pagine e nessuna coda.
In cosa differisce dalla copia del testo?
L'estrazione mantiene i livelli di intestazione, paragrafi, tabelle e immagini e il modo in cui sono correlati, in modo da ottenere dati strutturati anziché testo semplice.
Ho bisogno di un account?
SÌ. Accedi con un account OmniDoc; l'iscrizione è gratuita. Solo tu puoi vedere i file che carichi e i relativi risultati.
Dove scarico il risultato?
Scaricalo su questa pagina quando sarà pronto. L'estrazione viene eseguita in background, quindi lasciare la pagina non influisce; apri di nuovo questa pagina e accedi per trovare i file precedenti sotto "Estrazioni recenti".
E se l'estensione del file non corrisponde al formato reale?
Il formato reale viene rilevato dal contenuto del file. Ad esempio, un file .pdf che in realtà è un documento Word viene elaborato come .docx e torna come .docx. Salva prima i vecchi file .doc, .xls e .ppt come .docx, .xlsx e .pptx.
Devo installare qualcosa?
No, funziona nel browser. Per file con molte pagine o quando hai fretta, consigliamo l'app desktop OmniDoc per Windows, macOS e Linux: nessun limite di pagine e nessuna coda.
L'app desktop OmniDoc: fluida, supporto 100% Office XML, i nuovi standard nazionali della Cina
L'app desktop gratuita per Windows, macOS e Linux apre, modifica e salva i file sul proprio computer.