
Gratis documentextractie
Haal de koppen, alinea's, tabellen en afbeeldingen van PDF-bestanden, scans, Word, PowerPoint en Excel-bestanden uit in Markdown en JSON.
Maximaal 501 pagina's per PDF en geen maandelijkse limiet; gratis extracties wachten in een wachtrij. Voor grote bestanden of als u haast heeft, raden wij u aande OmniDoc desktop-app: geen paginalimiet en geen wachtrij.
Hoe converteer je een PDF naar Markdown en JSON
- 1Upload het bestandLog in met een OmniDoc-account, zet het bestand vervolgens in het bovenstaande gebied of klik op "Bestand kiezen".
- 2Begin met de extractiePDF bestanden, scans en afbeeldingen ondergaan lay-outanalyse, tekstherkenning en tabelherkenning; Word, PowerPoint en Excel bestanden, e-books en webpagina's worden direct ontleed.
- 3Download het resultaatAls het klaar is, download je een ZIP-bestand met de Markdown, de JSON en de afbeeldingen.
Voorbeeld
Pagina 1 van een rapport en de Markdown die daaruit is gehaald: kopniveaus, alinea's en tabellen worden bewaard.
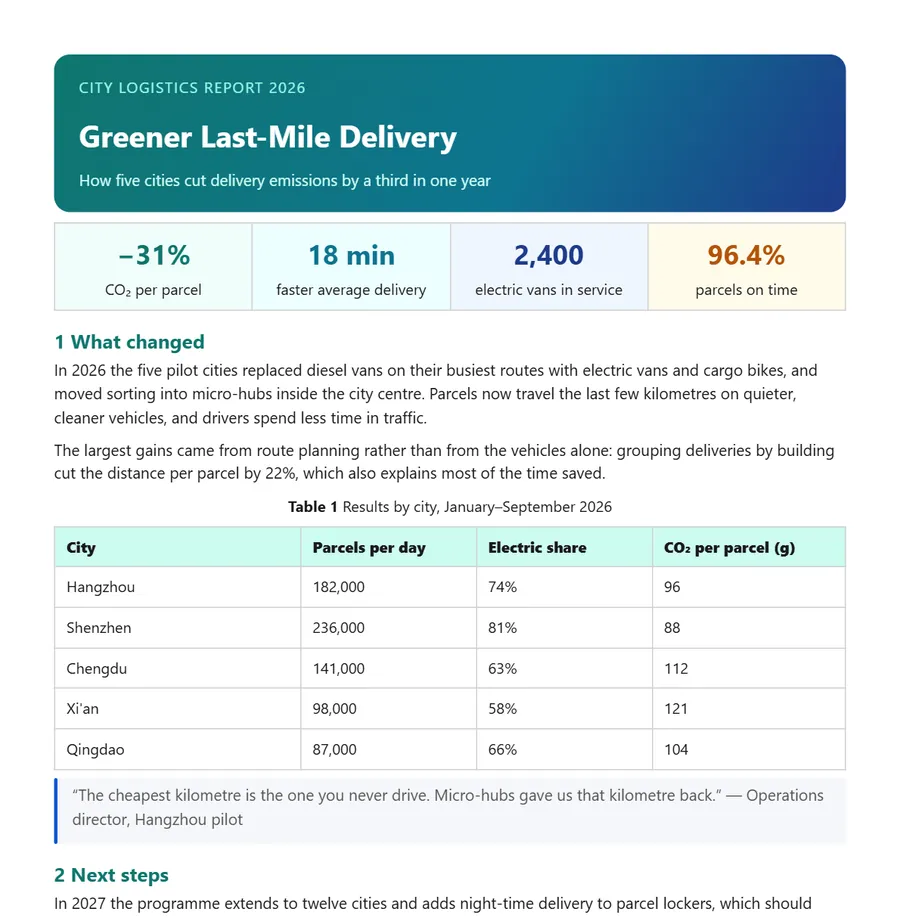
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
Het ZIP-bestand dat u downloadt, bevat
document.mdDe volledige tekst als Markdowndocument.jsonGestructureerde data in leesvolgordeimages/De afbeeldingen in het documentmanifest.jsonEen lijst met bestanden met basisinformatie
Ondersteunde formaten
| Bestand | Hoe het wordt verwerkt |
|---|---|
| PDF, gescande afbeeldingen van PDF, PNG, JPG, WEBP en BMP | Lay-outanalyse, tekstherkenning (OCR) en tabelherkenning |
| Word、PowerPoint、Excel、CSV | De documentstructuur wordt direct gelezen |
| EPUB e-boeken, HTML pagina's | Hoofdstukken en hoofdtekst worden geparseerd |
| Markdown, TXT, SRT en ASS ondertitels | Omgezet in dezelfde Markdown en JSON |
Vragen
Welke bestanden bevat het resultaat?
Eén ZIP-bestand met document.md (de volledige tekst als Markdown), document.json (gestructureerde data), images/ (de afbeeldingen) en manifest.json (een lijst van de bestanden).
Kunnen scans worden geëxtraheerd?
Ja. Gescande PDF-bestanden en afbeeldingen worden eerst herkend en daarna georganiseerd. Controleer de herkende tekst met het origineel, vooral cijfers en tabellen.
Wat zijn de grenzen van gratis extractie?
Tot 501 pagina's per PDF en geen maandelijkse limiet. Gratis extracties worden verwerkt in de volgorde waarin ze worden ingediend, dus de snelheid hangt af van de wachtrij. We doen ons best op het gebied van kwaliteit; Als een resultaat niet goed genoeg is, heb dan geduld met ons. Voor grote bestanden of wanneer je haast hebt, raden we de OmniDoc desktop-app aan: geen paginalimiet en geen wachtrij.
Hoe verschilt dit van het kopiëren van de tekst?
Extractie behoudt de kopniveaus, alinea's, tabellen en afbeeldingen en hoe ze zich ermee verhouden, zodat je gestructureerde data krijgt in plaats van platte tekst.
Heb ik een account nodig?
Ja. Log in met een OmniDoc-account; Aanmelden is gratis. Alleen jij kunt de bestanden die je uploadt en hun resultaten zien.
Waar download ik het resultaat?
Download het op deze pagina wanneer het klaar is. De extractie draait op de achtergrond, dus het verlaten van de pagina heeft geen invloed daarop; Open deze pagina opnieuw en log in om eerdere bestanden te vinden onder "Recente extracties".
Wat als de bestandsextensie niet overeenkomt met het echte formaat?
Het echte formaat wordt gedetecteerd uit de bestandsinhoud. Bijvoorbeeld, een .pdf bestand dat eigenlijk een Word-document is, wordt verwerkt als .docx en komt terug als .docx. Sla oude .doc, .xls en .ppt-bestanden eerst op als .docx, .xlsx en .pptx.
Moet ik iets installeren?
Nee, het draait in de browser. Voor bestanden met veel pagina's of wanneer je haast hebt, raden we de OmniDoc desktop-app aan voor Windows, macOS en Linux: geen paginalimiet en geen wachtrij.
De OmniDoc desktop-app: soepele, 100% Office XML-ondersteuning, China's nieuwe nationale normen
De gratis desktop-app voor Windows, macOS en Linux opent, bewerkt en bewaart bestanden op uw eigen computer.