
Darmowa ekstrakcja dokumentów
Wyodrębnij nagłówki, akapity, tabele i obrazy plików PDF, skanów, plików Word, PowerPoint i Excel do plików Markdown i JSON.
Do 501 stron na PDF i bez limitu miesięcznego; bezpłatne ekstrakty czekają w kolejce. W przypadku dużych plików lub gdy się spieszysz, polecamyaplikację komputerową OmniDoc: brak limitu stron i brak kolejki.
Jak przekształcić PDF w Markdown i JSON
- 1Prześlij plikZaloguj się na konto OmniDoc, a następnie umieść plik w górnym obszarze lub kliknij "Wybierz plik".
- 2Rozpocznij ekstrakcjępliki, skany i obrazy PDF przechodzą analizę układu, rozpoznawanie tekstu i rozpoznawanie tabel; Pliki, e-booki i strony internetowe Word, PowerPoint i Excel są analizowane bezpośrednio.
- 3Pobierz wynikPo zakończeniu pobierania pliku ZIP z Markdown, JSON i obrazami.
Przykład
Strona 1 raportu i wyodrębnione z niej elementy Markdown: poziomy nagłówków, akapity i tabele zostają zachowane.
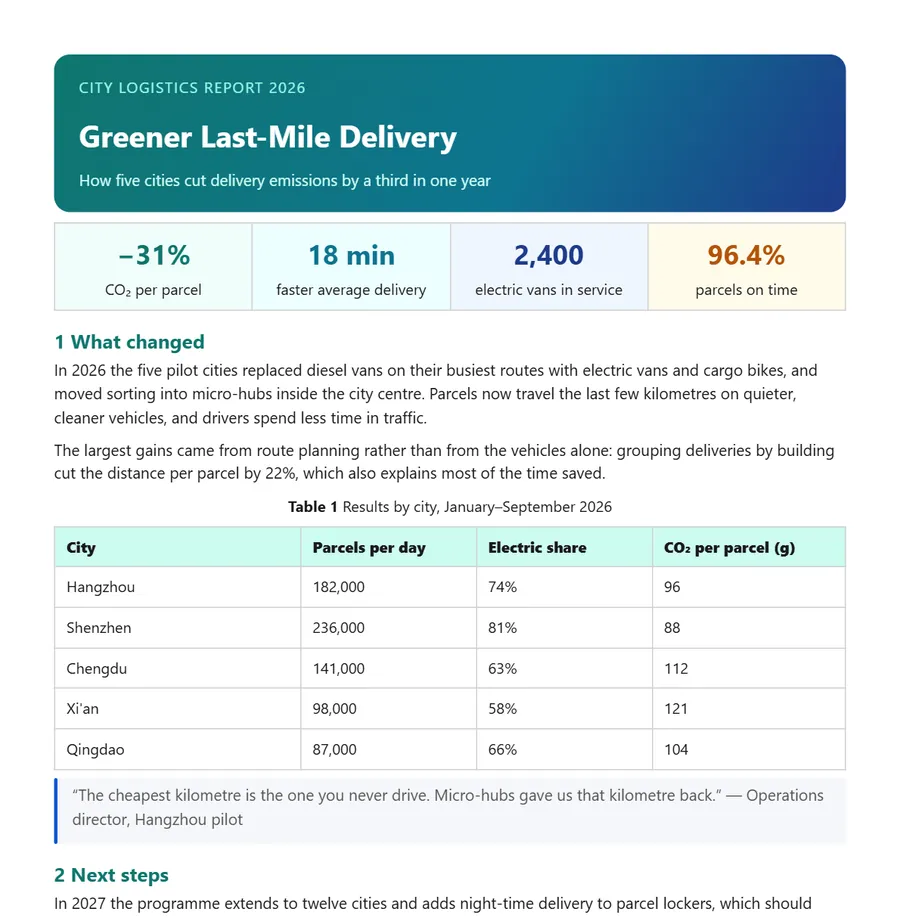
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
Pobrany plik ZIP zawiera
document.mdPełny tekst jako Markdowndocument.jsonDane strukturalne w kolejności odczytuimages/Zdjęcia w dokumenciemanifest.jsonLista plików z podstawowymi informacjami
Obsługiwane formaty
| Plik | Jak jest przetwarzany |
|---|---|
| PDF, zeskanowane obrazy PDF, PNG, JPG, WEBP i BMP | Analiza układu, rozpoznawanie tekstu (OCR) i rozpoznawanie tabeli |
| Word、PowerPoint、Excel、CSV | Struktura dokumentu jest odczytywana bezpośrednio |
| EPUB e-booki, HTML strony | Rozdziały i treść są analizowane |
| Napisy Markdown, TXT, SRT i ASS | Przeliczone na te same Markdown i JSON |
Pytania
Jakie pliki zawiera wynik?
Jeden plik ZIP zawierający document.md (pełny tekst jako Markdown), document.json (dane strukturalne), images/ (obrazy) oraz manifest.json (lista plików).
Czy skany można wyciągnąć?
Tak. Zeskanowane pliki i obrazy PDF są najpierw rozpoznawane, a następnie porządkowane. Porównaj rozpoznany tekst z oryginałem, szczególnie z liczbami i tabelami.
Jakie są granice swobodnej ekstrakcji?
Do 501 stron na PDF i bez limitu miesięcznego. Bezpłatne ekstrakty są przetwarzane w kolejności ich przesłania, więc prędkość zależy od kolejki. Dokładamy wszelkich starań w zakresie jakości; jeśli wynik nie jest wystarczająco dobry, prosimy o wyrozumiałość. W przypadku dużych plików lub gdy się spieszysz, zalecamy aplikację komputerową OmniDoc: bez limitu stron i bez kolejki.
Czym różni się to od kopiowania tekstu?
Ekstrakcja zachowuje poziomy nagłówków, akapitów, tabel i obrazów oraz ich wzajemne powiązania, dzięki czemu otrzymujesz uporządkowane dane, a nie zwykły tekst.
Czy potrzebuję konta?
Tak. Zaloguj się na konto OmniDoc; rejestracja jest bezpłatna. Tylko Ty możesz zobaczyć przesłane pliki i ich wyniki.
Gdzie mogę pobrać wynik?
Pobierz go na tej stronie, gdy będzie gotowy. Wyodrębnianie przebiega w tle, więc opuszczenie strony nie ma na to wpływu; otwórz tę stronę ponownie i zaloguj się, aby znaleźć wcześniejsze pliki w sekcji „Ostatnie ekstrakcje”.
Co jeśli rozszerzenie pliku nie odpowiada prawdziwemu formatowi?
Rzeczywisty format jest wykrywany na podstawie zawartości pliku. Na przykład plik .pdf, który jest w rzeczywistości dokumentem Word, jest przetwarzany jako .docx i wraca jako .docx. Zapisz stare pliki .doc, .xls i .ppt jako .docx, .xlsx i .pptx najpierw.
Czy muszę coś instalować?
Nie, działa w przeglądarce. Do plików z wieloma stronami lub gdy się spieszysz, polecamy aplikację desktopową OmniDoc dla Windows, macOS i Linux: brak limitu stron i brak kolejki.
Aplikacja komputerowa OmniDoc: płynna, w 100% obsługa pakietu Office XML, nowe standardy krajowe w Chinach
Bezpłatna aplikacja komputerowa dla Windows, macOS i Linux otwiera, edytuje i zapisuje pliki na Twoim komputerze.