
Extração gratuita de documentos
Extraia os títulos, parágrafos, tabelas e imagens de arquivos PDF, digitalizações, arquivos Word, PowerPoint e Excel em Markdown e JSON.
Até 501 páginas por PDF e sem limite mensal; extrações gratuitas esperam em uma fila. Para arquivos grandes ou quando você estiver com pressa, recomendamoso aplicativo de desktop OmniDoc: sem limite de páginas e sem fila.
Como converter um PDF para Markdown e JSON
- 1Carregar o arquivoFaça login com uma conta OmniDoc e solte o arquivo na área acima ou clique em “Escolher arquivo”.
- 2Inicie a extraçãoPDF arquivos, digitalizações e imagens passam por análise de layout, reconhecimento de texto e reconhecimento de tabela; Arquivos Word, PowerPoint e Excel, e-books e páginas da web são analisados diretamente.
- 3Baixe o resultadoQuando estiver pronto, baixe um arquivo ZIP com o Markdown, o JSON e as imagens.
Exemplo
Página 1 de um relatório e o Markdown extraído dele: níveis de título, parágrafos e tabelas são mantidos.
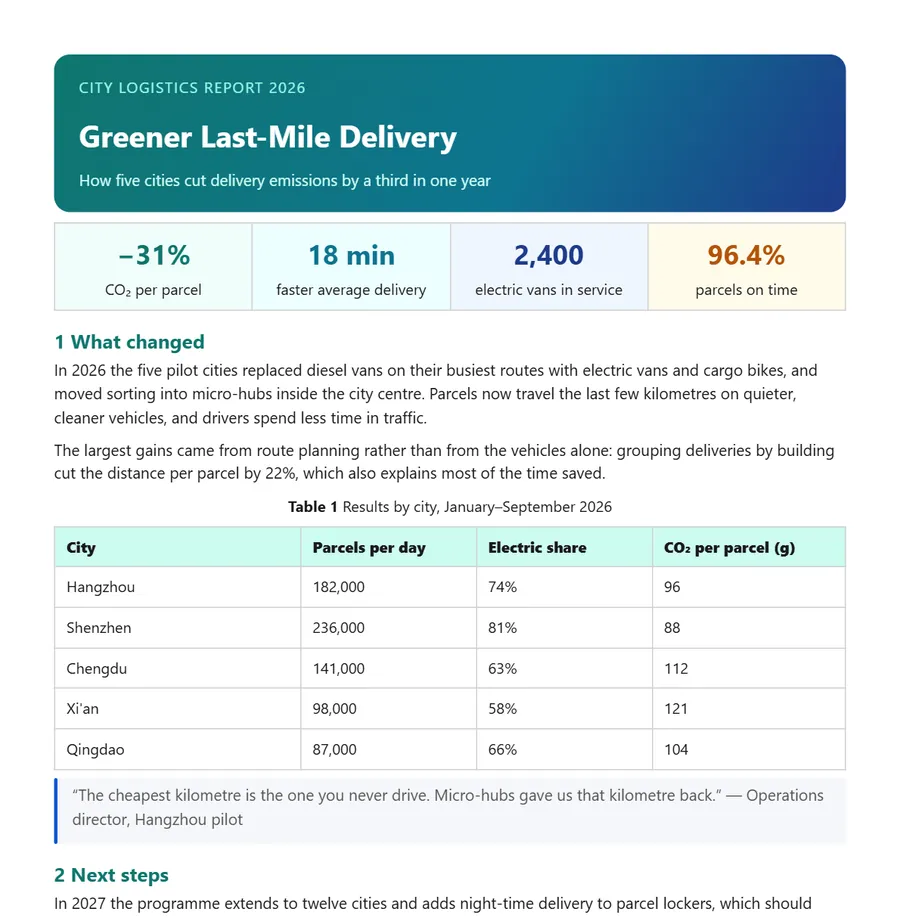
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
O arquivo ZIP que você baixa contém
document.mdO texto completo como Markdowndocument.jsonDados estruturados em ordem de leituraimages/As fotos no documentomanifest.jsonUma lista dos arquivos com informações básicas
Formatos suportados
| Arquivo | Como é processado |
|---|---|
| PDF, imagens digitalizadas PDF, PNG, JPG, WEBP e BMP | Análise de layout, reconhecimento de texto (OCR) e reconhecimento de tabela |
| Word、PowerPoint、Excel、CSV | A estrutura do documento é lida diretamente |
| EPUB e-books, HTML páginas | Capítulos e texto do corpo são analisados |
| Legendas Markdown, TXT, SRT e ASS | Convertidos nos mesmos Markdown e JSON |
Perguntas
Quais arquivos o resultado contém?
Um arquivo ZIP com document.md (o texto completo como Markdown), document.json (dados estruturados), images/ (as imagens) e manifest.json (uma lista dos arquivos).
As varreduras podem ser extraídas?
Sim. Arquivos e imagens PDF escaneados são reconhecidos primeiro e depois organizados. Verifique o texto reconhecido com o original, especialmente números e tabelas.
Quais são os limites da extração gratuita?
Até 501 páginas por PDF e sem limite mensal. As extrações gratuitas são processadas na ordem em que são enviadas, portanto a velocidade depende da fila. Fazemos o nosso melhor em qualidade; se o resultado não for bom o suficiente, tenha paciência conosco. Para arquivos grandes ou quando você estiver com pressa, recomendamos o aplicativo para desktop OmniDoc: sem limite de páginas e sem fila.
Como isso é diferente de copiar o texto?
A extração mantém os níveis de títulos, parágrafos, tabelas e imagens e como eles se relacionam, então você obtém dados estruturados em vez de texto simples.
Eu preciso de uma conta?
Sim. Faça login com uma conta OmniDoc; A inscrição é gratuita. Só você pode ver os arquivos que você envia e seus resultados.
Onde faço o download do resultado?
Baixe nesta página quando estiver pronto. A extração roda em segundo plano, então sair da página não afeta; abra esta página novamente e faça login para encontrar arquivos anteriores em "Extrações recentes".
E se a extensão do arquivo não corresponder ao formato real?
O formato real é detectado pelo conteúdo do arquivo. Por exemplo, um arquivo .pdf que na verdade é um documento Word é processado como .docx e retorna como .docx. Salve arquivos antigos .doc, .xls e .ppt como .docx, .xlsx e .pptx primeiro.
Preciso instalar alguma coisa?
Não, ele roda no navegador. Para arquivos com muitas páginas ou quando você está com pressa, recomendamos o aplicativo de desktop OmniDoc para Windows, macOS e Linux: sem limite de páginas e sem fila.
O aplicativo de desktop OmniDoc: suporte suave e 100% Office XML, os novos padrões nacionais da China
O aplicativo gratuito para desktop para Windows, macOS e Linux abre, edita e salva arquivos no seu próprio computador.