
Безкоштовне витягування документів
Витягніть заголовки, абзаци, таблиці та зображення файлів PDF, сканів, Word, PowerPoint та Excel у файли Markdown та JSON.
До 501 сторінки на PDF без місячного обмеження; безкоштовні вилучення чекають у черзі. Для великих файлів або коли ви поспішаєте, ми рекомендуємопрограму OmniDoc для комп’ютера: без обмеження сторінок і без черги.
Як перетворити PDF у Markdown та JSON
- 1Завантажити файлУвійдіть за допомогою облікового запису OmniDoc, потім перетягніть файл у область вище або натисніть «Вибрати файл».
- 2Починайте екстракціюPDF файли, скани та зображення проходять аналіз макета, розпізнавання тексту та розпізнавання таблиць; Файли Word, PowerPoint і Excel, електронні книги та веб-сторінки аналізуються безпосередньо.
- 3Завантажити результатПісля завершення завантажте файл ZIP з Markdown, JSON та зображеннями.
Приклад
Сторінка 1 звіту та витягнуті з неї Markdown: рівні заголовків, абзаци та таблиці зберігаються.
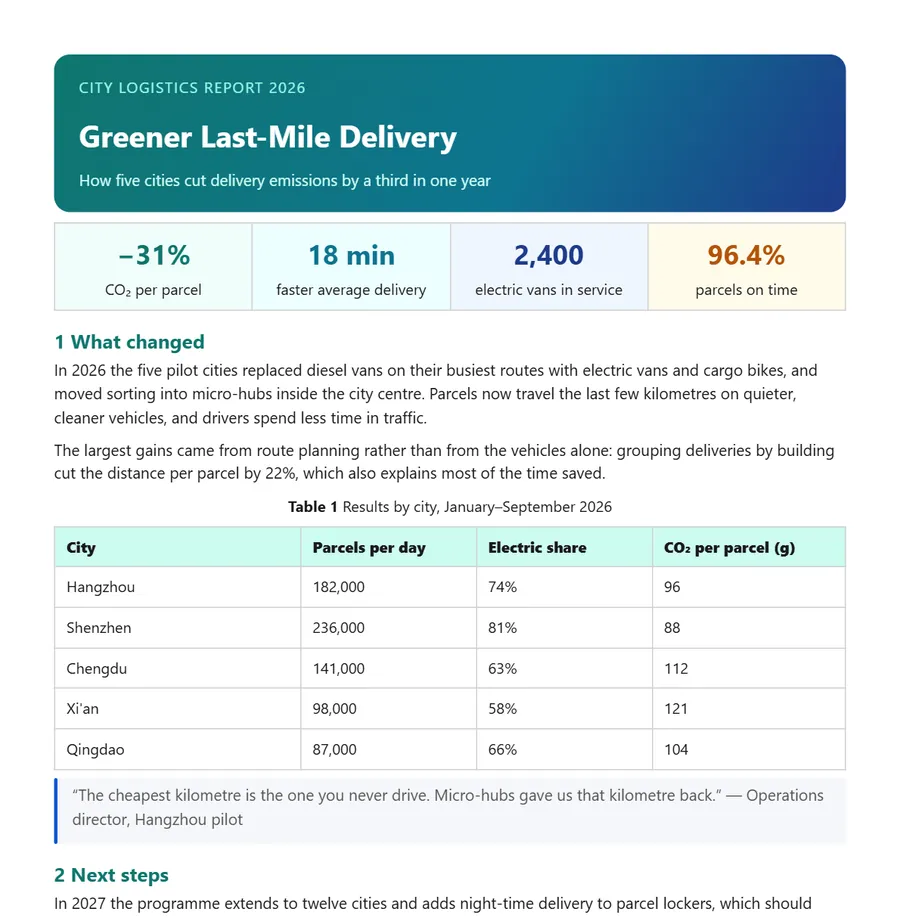
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
Файл ZIP, який ви завантажуєте, містить
document.mdПовний текст як Markdowndocument.jsonСтруктуровані дані у порядку читанняimages/Фотографії в документіmanifest.jsonСписок файлів з базовою інформацією
Підтримувані формати
| Файл | Як це обробляється |
|---|---|
| PDF, відскановані зображення PDF, PNG, JPG, WEBP та BMP | Аналіз верстки, розпізнавання тексту (OCR) та розпізнавання таблиць |
| Word、PowerPoint、Excel、CSV | Структура документа читається безпосередньо |
| EPUB електронних книг, HTML сторінок | Розділи та основний текст розбираються |
| Субтитри Markdown, TXT, SRT і ASS | Перетворено у однакові Markdown та JSON |
Питання
Які файли містить результат?
Один файл ZIP з document.md (повний текст як Markdown), document.json (структуровані дані), images/ (зображення) та manifest.json (список файлів).
Чи можна витягнути скани?
Так. Спочатку розпізнаються відскановані файли та зображення PDF, а потім організовані. Перевірте розпізнаний текст із оригіналом, особливо числами та таблицями.
Які межі безкоштовної екстракції?
До 501 сторінки на PDF і без місячного ліміту. Безкоштовні вилучення обробляються у порядку подачі, тому швидкість залежить від черги. Ми робимо все можливе для якості; Якщо результат недостатній, будь ласка, будьте терплячі. Для великих файлів або коли ви поспішаєте, ми рекомендуємо десктопний додаток OmniDoc: без обмеження сторінок і без черги.
Чим це відрізняється від копіювання тексту?
Екстракція зберігає рівні заголовків, абзаців, таблиць і зображень і те, як вони пов’язані, тому ви отримуєте структуровані дані, а не звичайний текст.
Чи потрібен мені акаунт?
так Увійдіть за допомогою облікового запису OmniDoc; реєстрація безкоштовна. Тільки ви можете бачити завантажені вами файли та їх результати.
Де мені завантажити результат?
Завантажте його на цій сторінці, коли він буде готовий. Видобування виконується у фоновому режимі, тому вихід зі сторінки не впливає на нього; знову відкрийте цю сторінку та ввійдіть, щоб знайти більш ранні файли в розділі «Останні вилучення».
Що робити, якщо розширення файлу не відповідає реальному формату?
Справжній формат визначається за вмістом файлу. Наприклад, файл .pdf, який насправді є документом Word, обробляється як .docx і повертається як .docx. Спочатку збережіть старі файли .doc, .xls і .ppt як .docx, .xlsx і .pptx.
Чи потрібно щось встановлювати?
Ні, він працює в браузері. Для файлів із великою кількістю сторінок або коли ви поспішаєте, ми рекомендуємо настільну програму OmniDoc для Windows, macOS і Linux: без обмеження сторінок і без черги.
Програма для настільних ПК OmniDoc: плавна, 100% підтримка Office XML, нові національні стандарти Китаю
Безкоштовний десктопний додаток для Windows, macOS та Linux відкриває, редагує та зберігає файли на вашому комп'ютері.